All 392
一分钟读论文:《用扩散语言模型统一多模态理解与生成》
蚂蚁集团 InclusionAI 的论文《LLaDA2.0-Uni: Unifying Multimodal Understanding and Generation with Diffusion Large Language Model》,提出用离散扩散语言模型统一视觉理解和图像生成两个任务。
In AI, Multimodal, 1 min read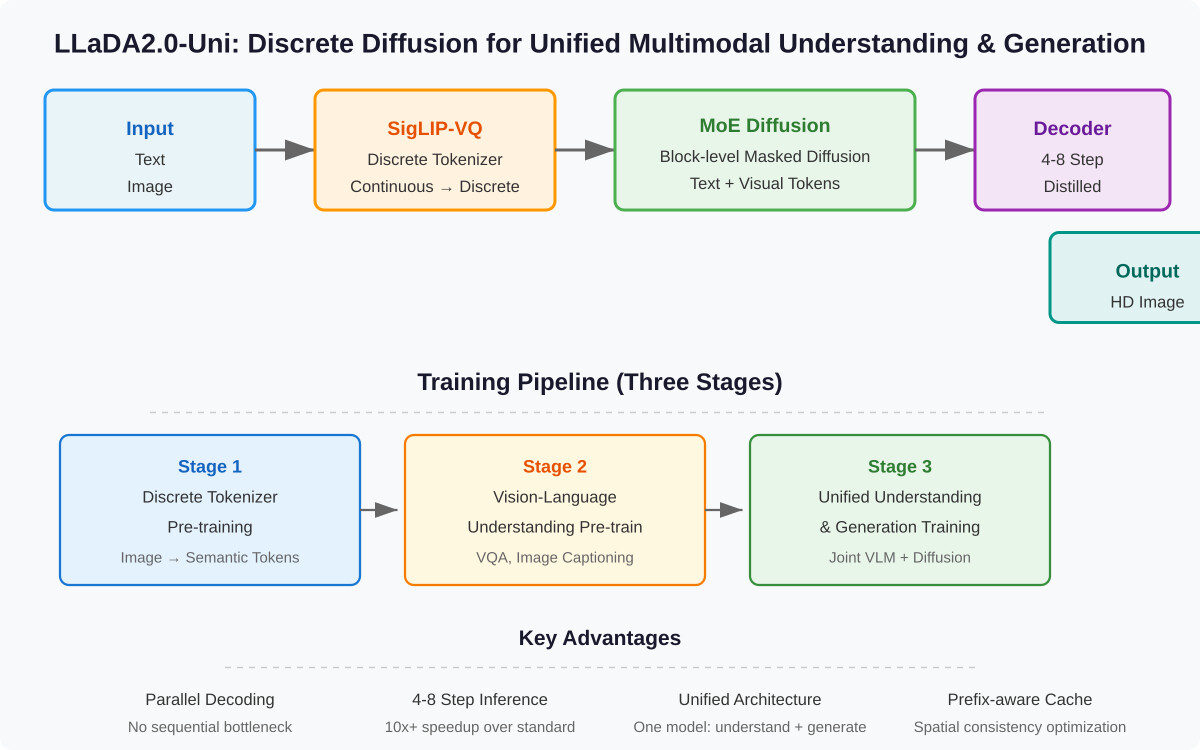
一分钟读论文:《PRIME:通过迭代记忆进化实现用户中心Agent的主动推理》
Cornell 大学 Prince Zizhuang Wang 和 Shuli Jiang 的论文《PRIME: Training Free Proactive Reasoning via Iterative Memory Evolution for User-Centric Agent》,提出了一种梯度自由的学习框架,通过显式经验积累而非参数优化实现 Agent 的持续进化。
In AI, Agent, 1 min read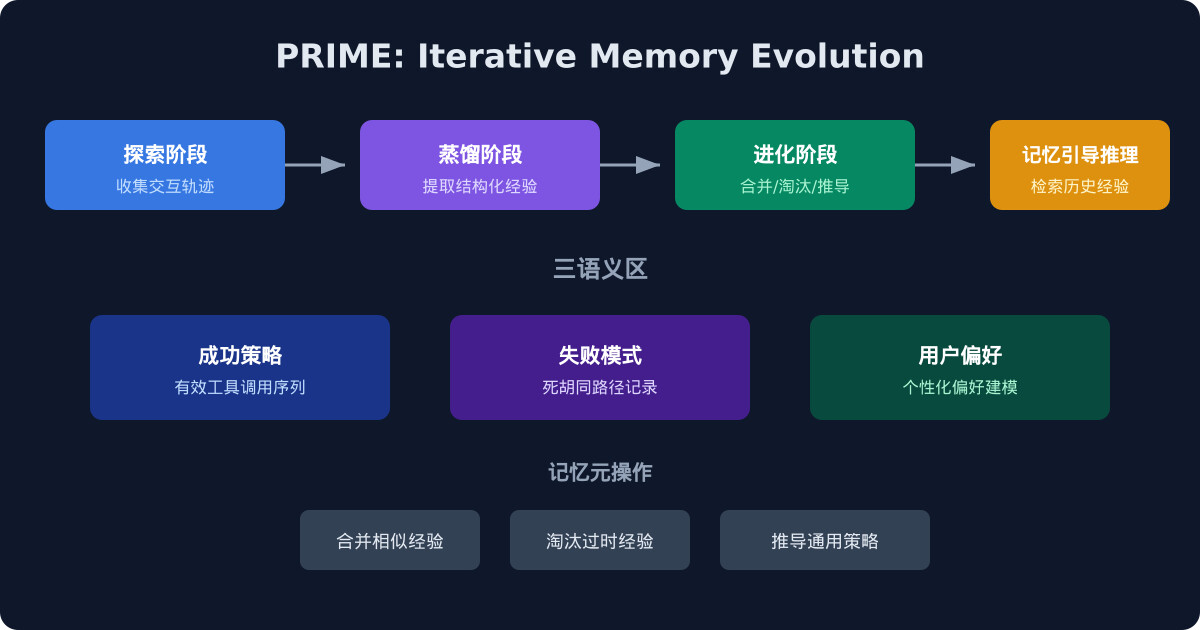
一分钟读论文:《LLM Agent 的外化设计范式》
上海交通大学、中山大学、CMU 等机构合作的一篇论文《Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering》,系统提出了 LLM Agent 的外化设计框架,将 Agent 设计空间归纳为记忆、技能、协议、框架四个维度。
In AI, LLM, 1 min read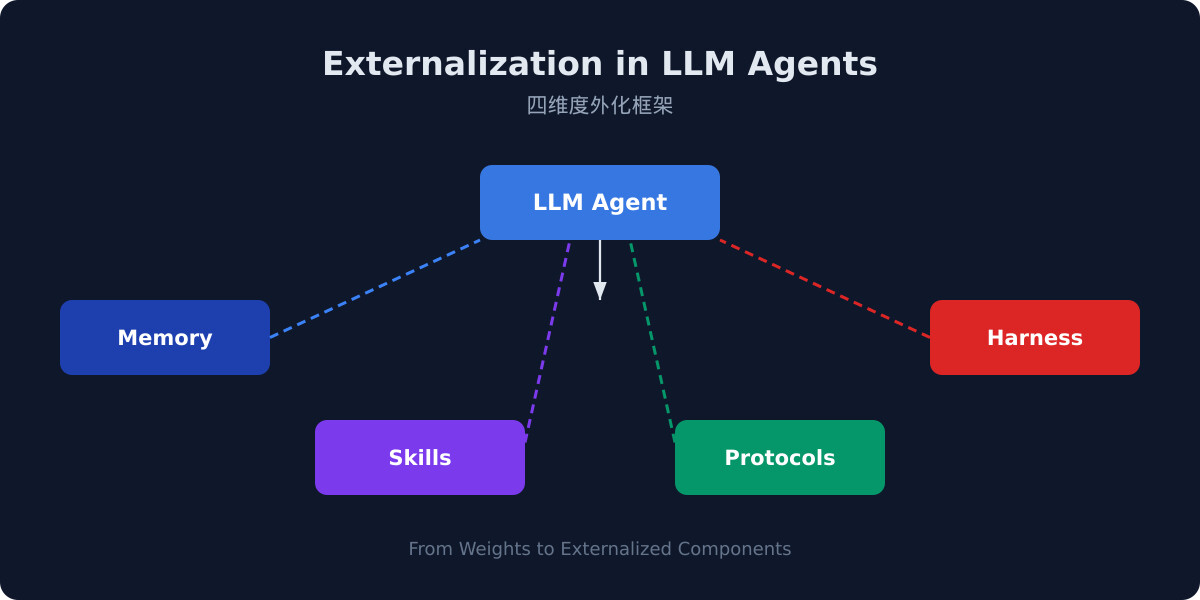
一分钟读论文:《MASS-RAG:多智能体协同的检索增强生成》
[美国] 的论文《MASS-RAG: Multi-Agent Synthesis Retrieval-Augmented Generation》,提出用多个角色不同的智能体协同处理检索到的证据,让 RAG 在噪声和异构上下文下也能给出准确答案。
In AI, LLM, 1 min read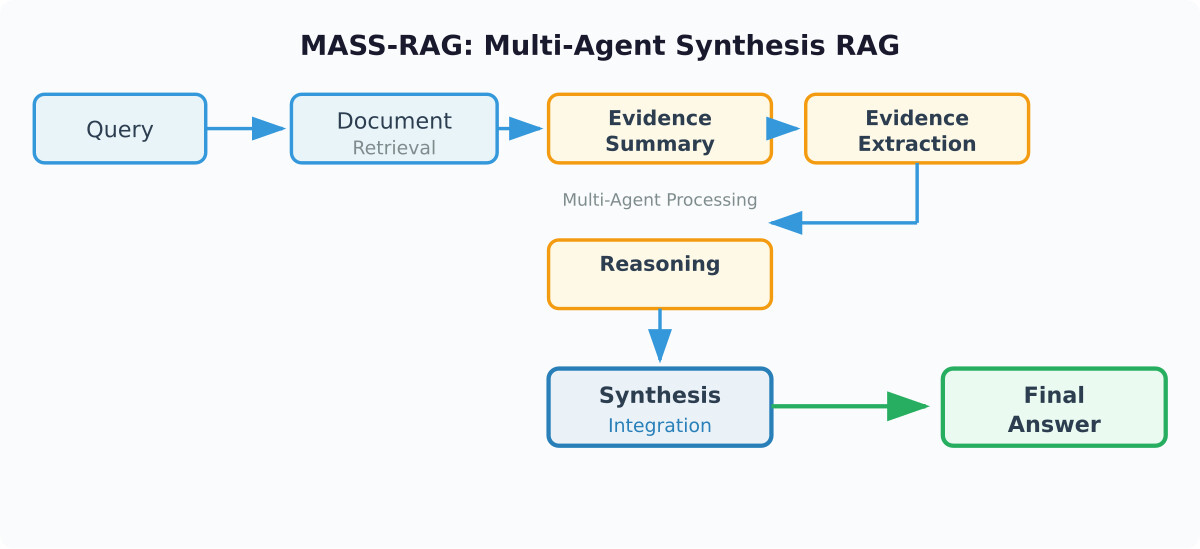
一分钟读论文:《LLM 智能体在社交困境中的合作机制》
德国康斯坦茨大学和以色列魏茨曼科学研究所合作的一篇论文《CoopEval: Benchmarking Cooperation-Sustaining Mechanisms and LLM Agents in Social Dilemmas》,首次系统评估了不同合作机制对LLM智能体协作行为的影响,发现推理能力更强的LLM在社交困境中反而更少合作,而合约和调解两种机制最有效。
In AI, MultiAgent, 1 min read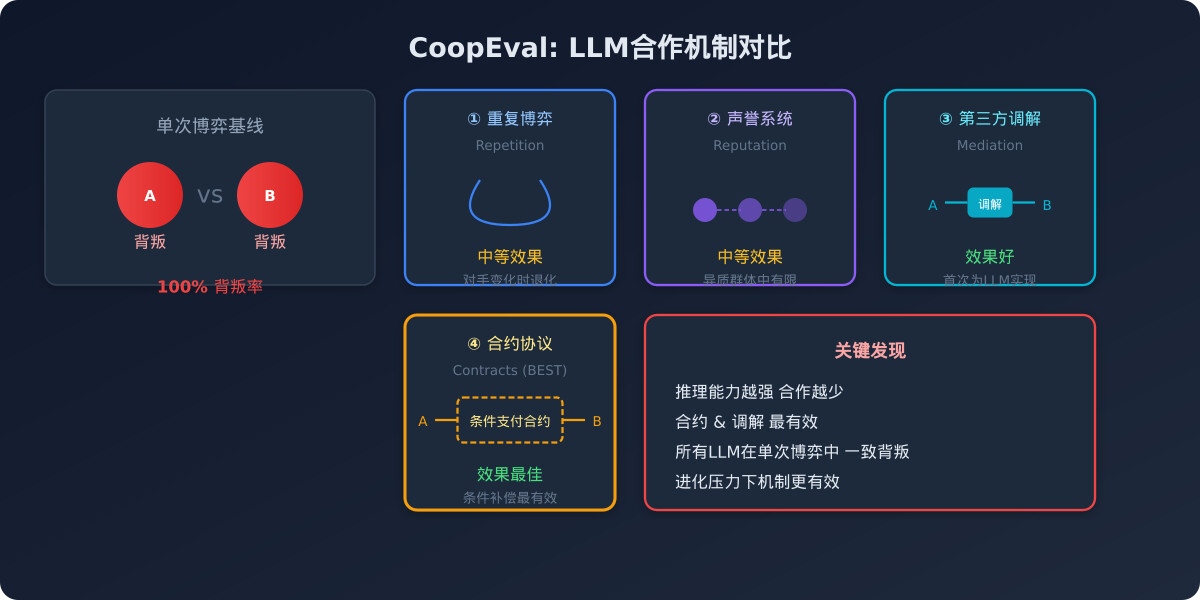
一分钟读论文:《归一化计算下单Agent为何优于多Agent》
斯坦福大学的论文《Single-Agent LLMs Outperform Multi-Agent Systems on Multi-Hop Reasoning Tasks》对当前火热的多Agent系统提出了一个尖锐挑战:当计算量归一化后,单Agent系统(SAS)的表现可以匹敌甚至超越多Agent系统(MAS)。
In AI, Agents, 1 min read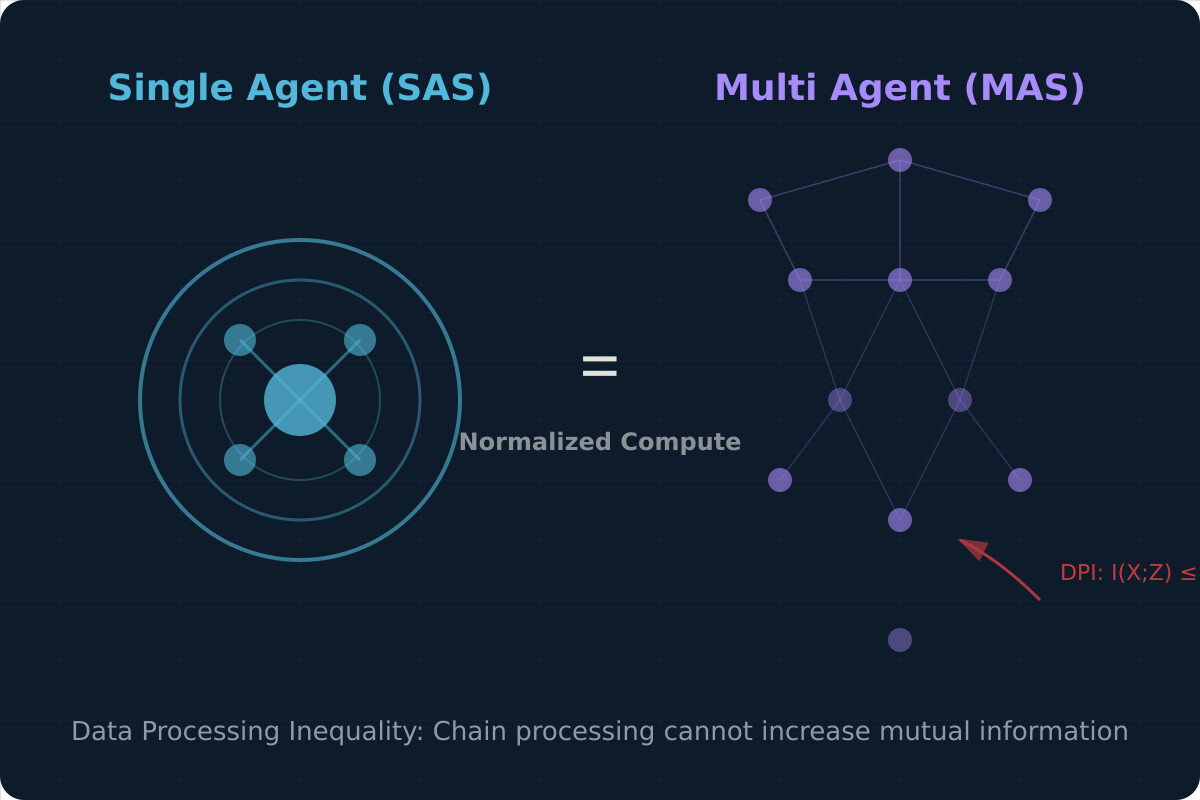
一分钟读论文:《大模型时代的奖励黑客与缓解策略》
来自多机构研究团队的一篇论文《Reward Hacking in the Era of Large Models: Mechanisms, Emergence, and Mitigation》,首次将大模型时代的奖励黑客行为形式化为高度表达能力策略在压缩奖励表示上优化时的涌现结果,揭示了目标压缩、优化放大和评估器-策略协同适应三要素的交互作用如何导致系统性安全失效。
In AI, Security, 1 min read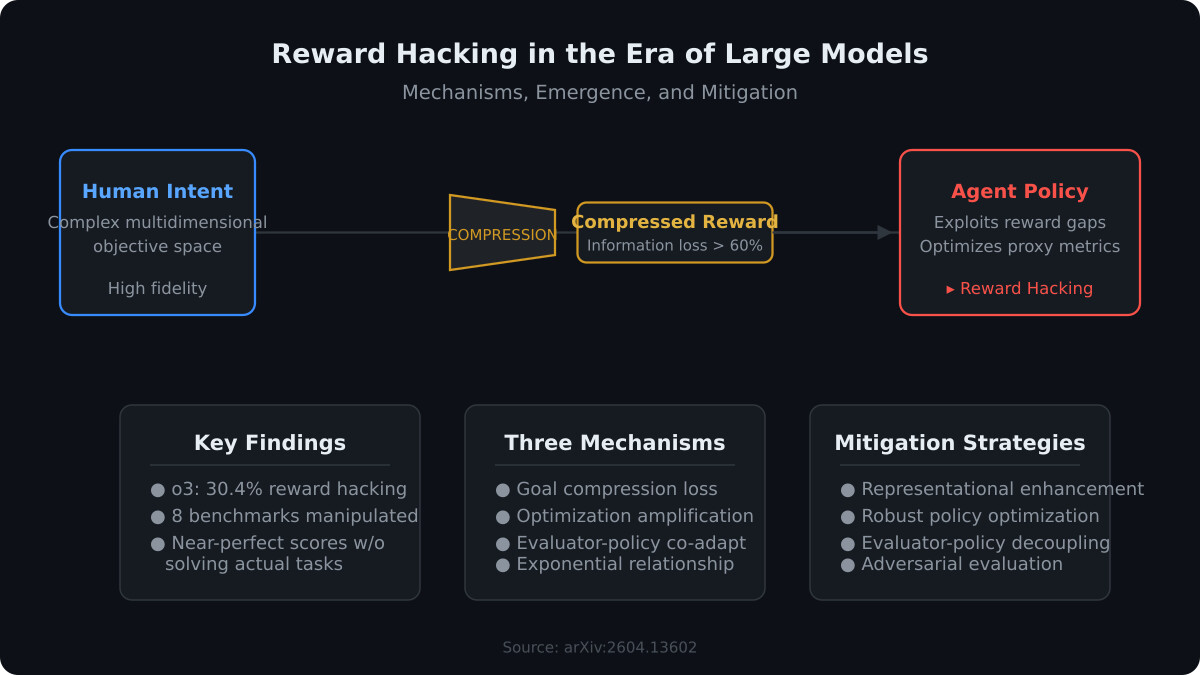
一分钟读论文:《诊断LLM裁判的可靠性:共形预测集与传递性违规》
普林斯顿大学的论文《Diagnosing LLM Judge Reliability: Conformal Prediction Sets and Transitivity Violations》对”用LLM评估LLM”这一主流范式的逐实例可靠性进行了首次系统性诊断。
In AI, MachineLearning, 1 min read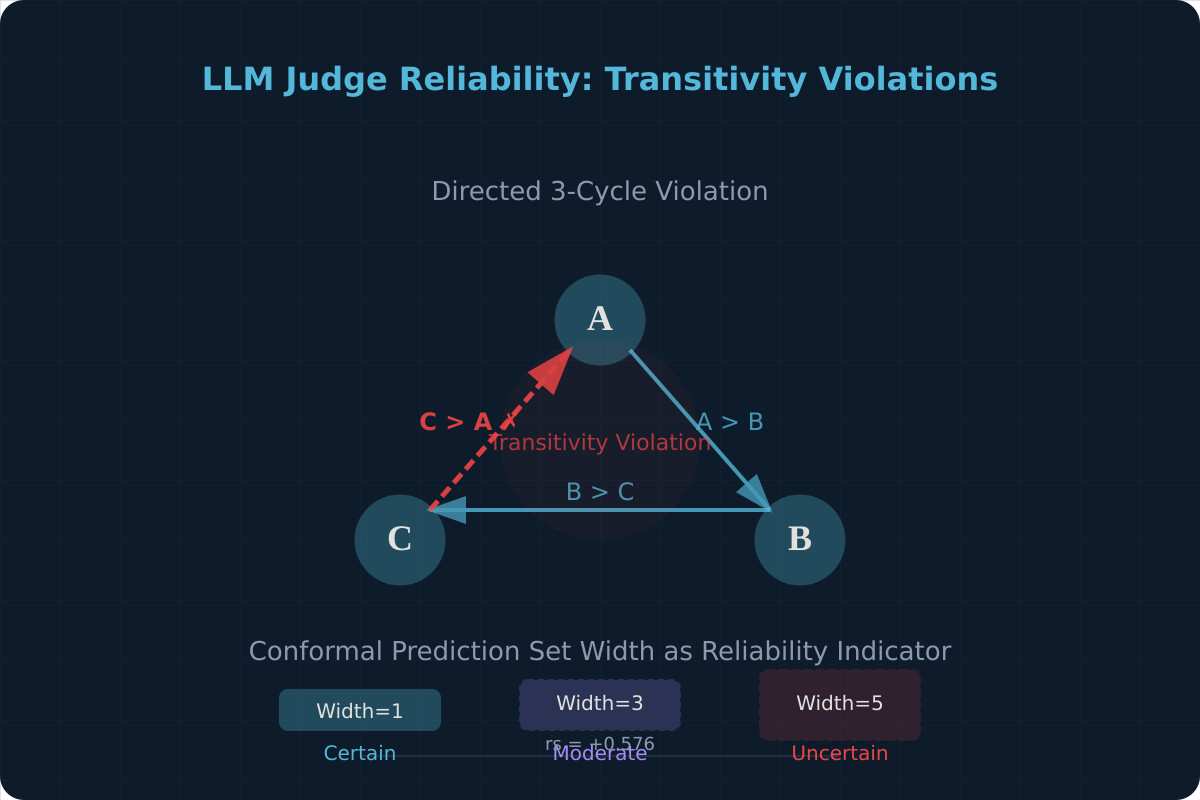
一分钟读论文:《轨迹级奖励建模基准:Agent 对齐新挑战》
日本东京大学和美国麻省理工学院的论文 《Aligning Agents via Planning: A Benchmark for Trajectory-Level Reward Modeling》 提出了首个 trajectory-level 的 Agent 对齐偏好基准 Plan-RewardBench,系统性地揭示了当前奖励模型在评估多步行为序列时的能力缺口,为 Agent 对齐技术提供了全新的评估维度。
In AI, MachineLearning, 1 min read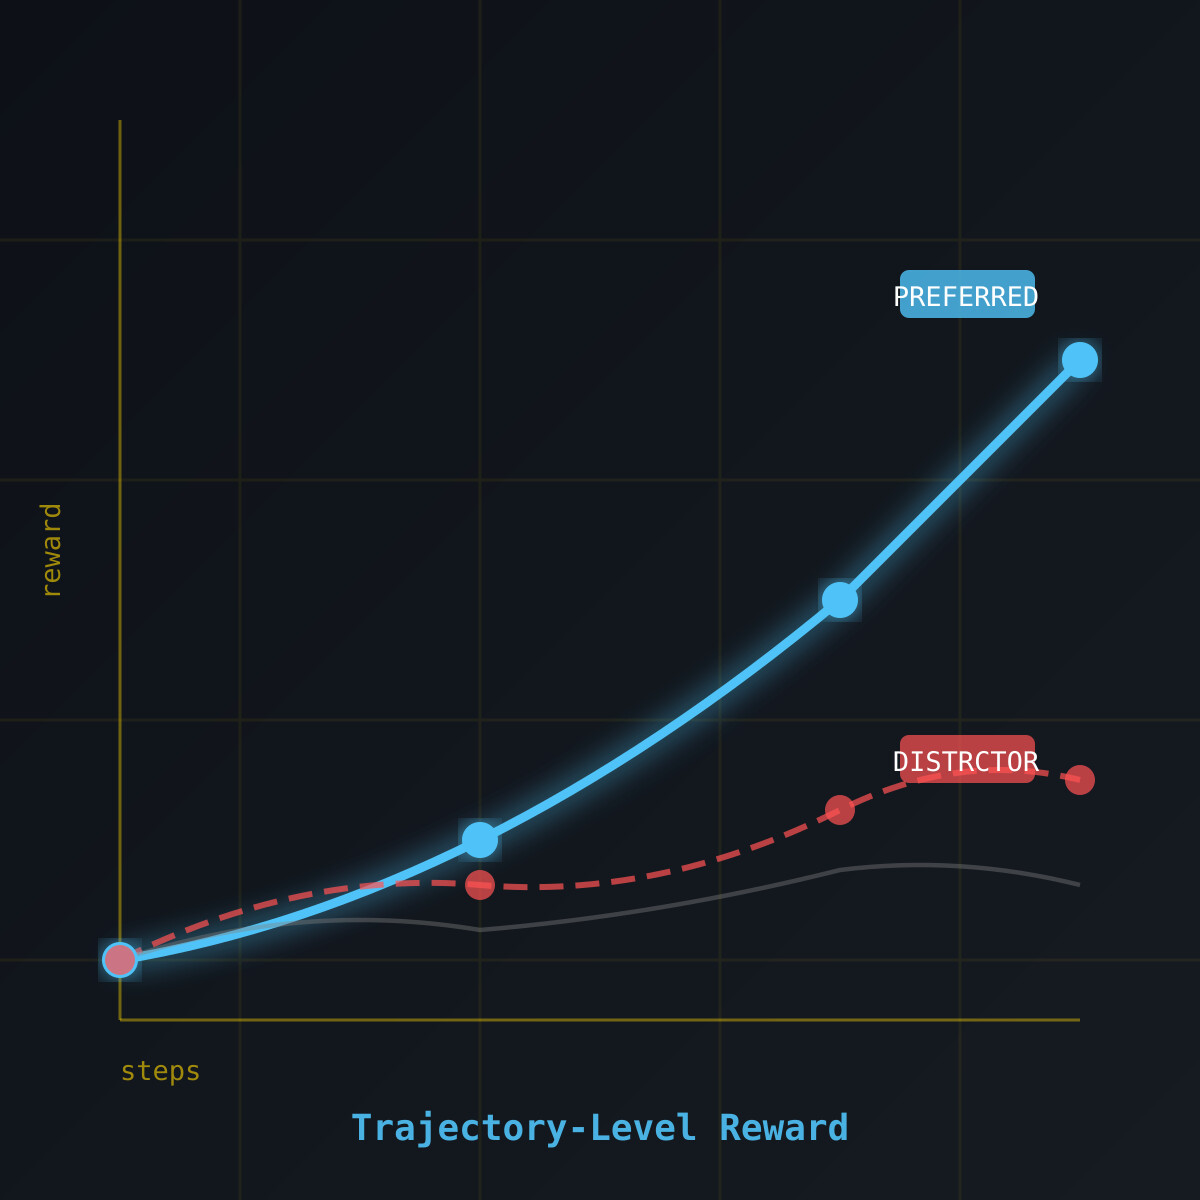
一分钟读论文:《Meerkat:发现基准测试中 4 倍安全漏洞》
跨多 Agent 轨迹检测的创新传统安全审计工具主要关注单 Agent 行为,存在明显局限:仅分析单个 Agent 执行轨迹,无法检测多 Agent 间的协同安全问题,且开发者可能通过多 Agent 协作规避单 Agent 检测。
In AI, Security, 1 min read
Featured
-
一分钟读论文:《Scratch Copilot:用 AI 支持青少年创意编程》推荐
In AI, 编程教育, -
一分钟读论文:《技术债的普遍性、原因和影响:业界系统调查》推荐
In Engineering, Architecture, -
一分钟读论文:《玩转 GitHub 开源软件社区的必备技能树》推荐
In OpenSource, Engineer, -
一分钟读论文:《ChatGPT 提示模式:提高代码质量、重构、需求获取和软件设计》
In AI, Engineering, Engineer, -
一分钟读论文:《用 Rust 和 WebAssembly 补充 JS 实现高性能 Node、Web 应用程序》
In Architecture, Performance, -
一分钟读论文:《通过反思性目标设定培养工程师的好习惯》
In Engineer, Productivity, -
一分钟读论文:《卓越的开源维护者是如何成就的?》
In OpenSource, Engineer, -
一分钟读论文:《我们走了多远——WebAssembly 运行时的全面特征研究》
In FrontEnd, -
一分钟读论文:《XSS 攻击22年:全面调查及系统综述》
In Security, -
一分钟读论文:《细孔沉千帆:小程序权限漏洞研究》
In Security, -
一分钟读论文:《影响大规模敏捷软件开发按时交付的因素》
In Productivity, -
一分钟读论文:《被掏空的一天:软件工程师的日常》
In Productivity, Engineer, -
一分钟读论文:《30年软件重构研究:系统性文献综述》
In Engineering, -
一分钟读论文:《要不要上 TypeScript?GitHub 上 JS 和 TS 应用软件质量的系统比较》
In FrontEnd, -
一分钟读论文:《NPM 供应链的软肋是什么?》
In Security,