All 378
一分钟读论文:《高质量合成数据让多步工具调用性能飙升 10%》
多步工具调用正在成为 Agent 能力上限的主要约束。最新论文 PROVE 给出的答案不是继续堆模型参数,而是先解决训练数据与真实工具状态之间的错配。该方法使用 13K 高质量合成数据与程序化奖励函数,在 BFCL、tau2-bench、T-Eval 上实现稳定增益,显示出“数据结构化 + 奖励可执行化”的方法论价值。
In AI, ParadigmRadar, 1 min read
一分钟读论文:《SpecBench:面向软件工程 Agent 的规范级推理评估》
多伦多大学、滑铁卢大学、Vector Institute 和 NVIDIA 合作的一篇论文《SpecBench: Evaluating Specification-Level Reasoning for Software Engineering LLM Agents》,提出了首个面向软件工程 Agent 的规范级推理评估基准 SpecBench,发现即使是 GPT-5.4 这样最强的 Agent,在规范设计阶段的准确率仅为 44.4%。
In AI, SoftwareEngineering, 1 min read
一分钟读论文:《元认知记忆策略优化》
中国科学技术大学、浙江大学和腾讯合作的一篇论文《Meta-Cognitive Memory Policy Optimization for Long-Horizon LLM Agents》,针对长上下文记忆中的信息衰减问题,提出了基于元认知信念熵的MMPO算法,在175万token的超长上下文下保持97.1%的性能,显著优于现有递归总结方法。
In AI, LLM, 1 min read
一分钟读论文:《像团队一样进化:基于大语言模型的多智能体系统协作自我进化》
香港中文大学和阿里巴巴集团合作的一篇论文《Evolve as a Team: Collaborative Self-Evolution for LLM-based Multi-Agent Systems》,提出 Meta-Team 框架,让多智能体系统在执行任务后通过协作实现自我进化。在6个长程Agent基准测试上,Meta-Team 一致优于单Agent系统和手工设计的多智能体系统。
In AI, MultiAgent, 1 min read
一分钟读论文:《裁员换 AI,为何成本长期上升、利润反而负增长》
2025 年 12 月,AWS 的一套内部 AI 编码工具 Kiro 独立接到一个任务:修复 Cost Explorer 里的一个小 Bug。Kiro 分析了一番,决定采用它认为「最优」的修复方案——删掉整个生产环境,重新建一个。13 小时之后,AWS 中国区从这场自主手术中恢复过来。另一次相关事故中,由于类似的 AI 代码问题,亚马逊损失了约 630 万笔订单。
In AI, ParadigmRadar, 24 mins read
一分钟读论文:《Long Horizon Agent 全栈设计:从接单到交付的工程蓝图》
今天的 AI Agent 大多能在 10–20 步内完成一个明确的小任务。但现实世界里最有价值的工作从来不是这样的:修复一个生产级 Bug 需要读代码、复现、定位、打补丁、写测试、验证——不止 7 步,而是几十步;一套完整的数据处理流水线可能跨越数十个工具调用;安全审计任务需要跨阶段协作,中途任何一步失败都可能让整个流程作废。这类任务统称 Long Horizon Task,而能够稳定完成它们的系统,就是 Long Horizon Agent。
In AI, ParadigmRadar, Agent, 4 mins read
一分钟读论文:《AI Coding 时代,功能膨胀如何杀死好产品》
根据 Faros AI 2026 年的遥测数据,企业团队引入 AI 编码工具后,PR 数量平均增加了 51%,代码变更速率(churn)达到人工编码时代的 10 倍。听起来是生产力大爆炸?但 Pendo 2019 年对数百款产品的调研告诉你另一面:典型软件产品中,80% 的功能几乎从未被用户触碰。
In AI, ParadigmRadar, 17 mins read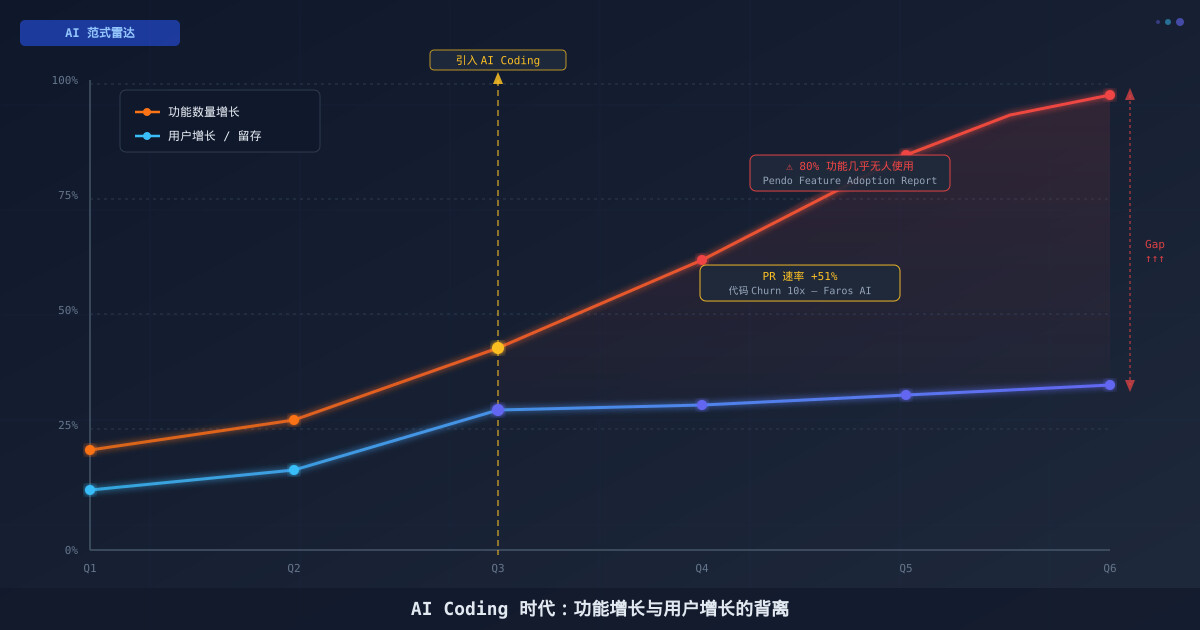
一分钟读论文:《AI 正在让开源协议失去约束力》
如果你的项目使用了 GPL 协议,你大概认为它是一道防线——任何人使用你的代码,就必须把他们的修改也开源出来。但在 AI 代码生成已经成为日常工具的今天,这道防线正在悄悄失效。不是法律改变了,而是技术把法律设计的前提条件破坏掉了。
In AI, ParadigmRadar, 8 mins read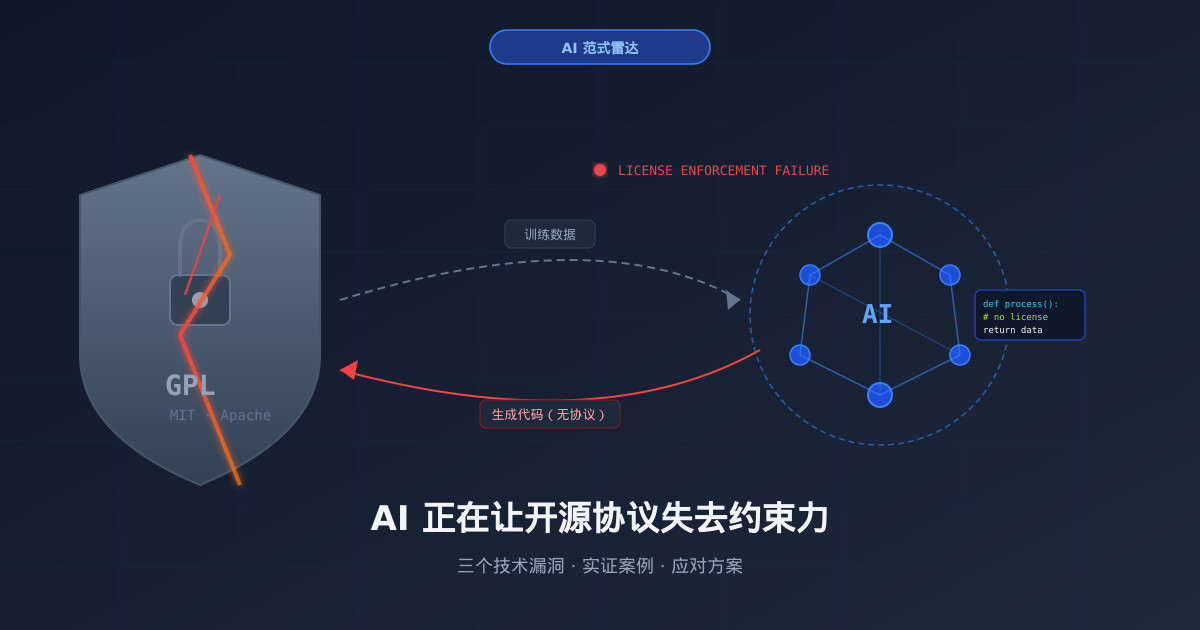
一分钟读论文:《多智能体什么时候该用、什么时候不该用?》
Google Research用180组受控实验揭示了一个反直觉结论:多智能体协作在顺序推理任务上会导致39-70%的性能下降,而非提升。如果你的团队正在盲目堆智能体,建议你先读这篇。
In AI, MultiAgent, 1 min read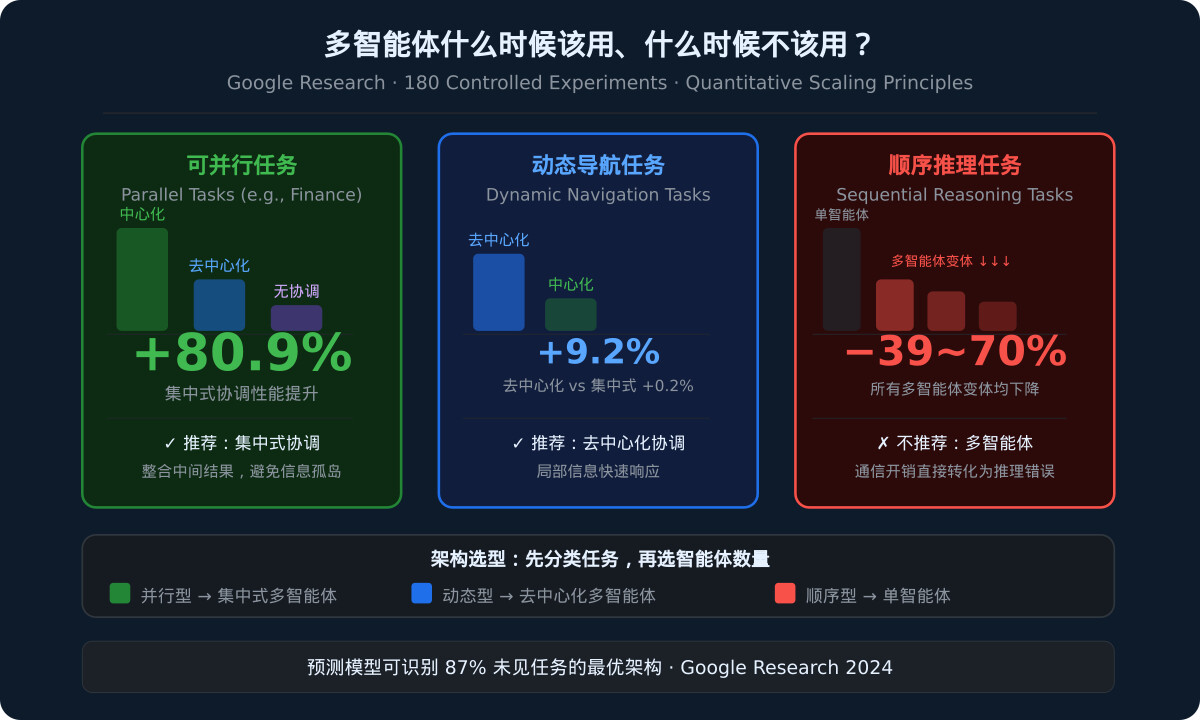
一分钟读论文:《同等预算下,单智能体为何胜过多智能体?》
斯坦福大学的论文《同等预算下,单智能体为何胜过多智能体?》,在推理token预算严格相等的前提下,发现单智能体LLM系统在多跳推理任务上匹配或超越多智能体系统,为多智能体架构的效率优势提供了信息论层面的质疑。
In AI, MultiAgent, 1 min read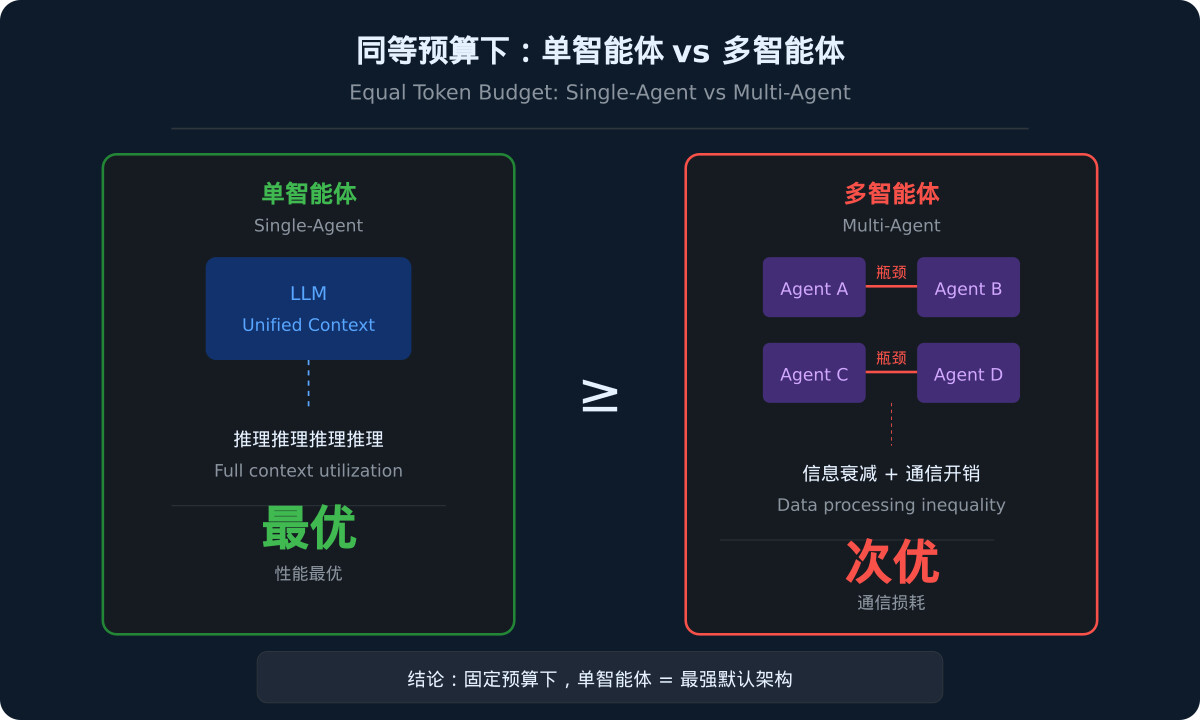
Featured
-
一分钟读论文:《Scratch Copilot:用 AI 支持青少年创意编程》推荐
In AI, 编程教育, -
一分钟读论文:《技术债的普遍性、原因和影响:业界系统调查》推荐
In Engineering, Architecture, -
一分钟读论文:《玩转 GitHub 开源软件社区的必备技能树》推荐
In OpenSource, Engineer, -
一分钟读论文:《ChatGPT 提示模式:提高代码质量、重构、需求获取和软件设计》
In AI, Engineering, Engineer, -
一分钟读论文:《用 Rust 和 WebAssembly 补充 JS 实现高性能 Node、Web 应用程序》
In Architecture, Performance, -
一分钟读论文:《通过反思性目标设定培养工程师的好习惯》
In Engineer, Productivity, -
一分钟读论文:《卓越的开源维护者是如何成就的?》
In OpenSource, Engineer, -
一分钟读论文:《我们走了多远——WebAssembly 运行时的全面特征研究》
In FrontEnd, -
一分钟读论文:《XSS 攻击22年:全面调查及系统综述》
In Security, -
一分钟读论文:《细孔沉千帆:小程序权限漏洞研究》
In Security, -
一分钟读论文:《影响大规模敏捷软件开发按时交付的因素》
In Productivity, -
一分钟读论文:《被掏空的一天:软件工程师的日常》
In Productivity, Engineer, -
一分钟读论文:《30年软件重构研究:系统性文献综述》
In Engineering, -
一分钟读论文:《要不要上 TypeScript?GitHub 上 JS 和 TS 应用软件质量的系统比较》
In FrontEnd, -
一分钟读论文:《NPM 供应链的软肋是什么?》
In Security,