All 386
AI 范式雷达:《WebSwarm:从并行到递归的协同搜索》
上周阿里巴巴达摩院发布了 WebSwarm——一个渐进式递归多Agent搜索框架。
In AI, ParadigmRadar, 3 mins read
AI 范式雷达:《EvoSOP:从原子操作到标准流程》
如果你正在构建或部署 AI 智能体,你可能已经注意到一个令人沮丧的模式:同一个 Agent 框架,跑十个任务可能要用掉二十种不同的工具组合。
In AI, ParadigmRadar, 4 mins read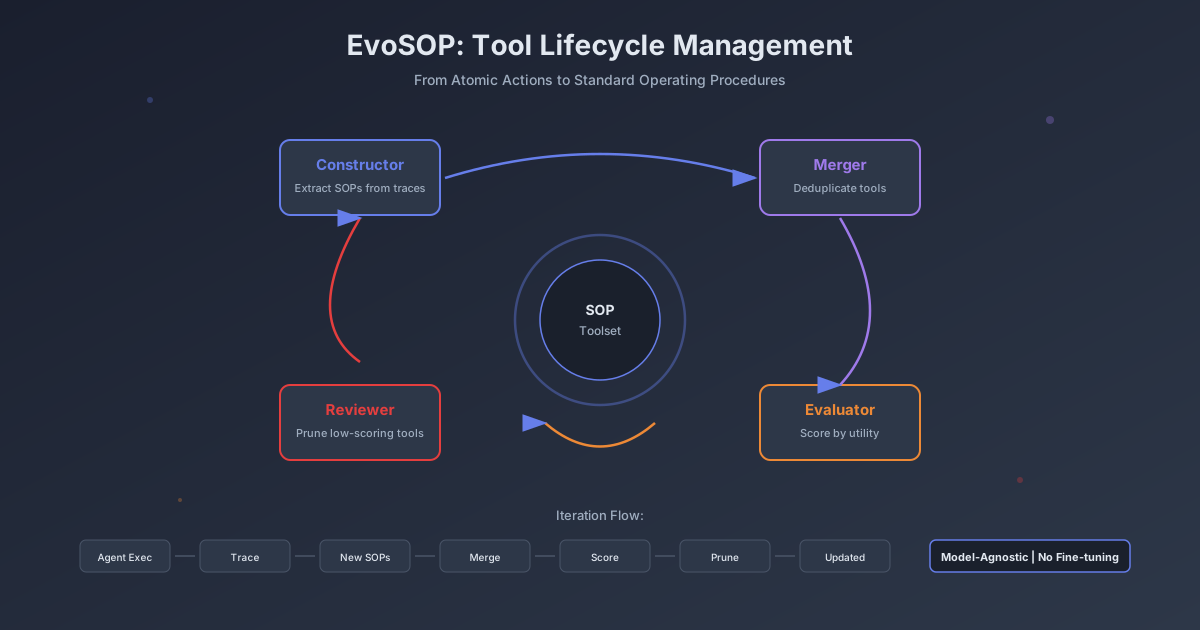
一分钟读论文:《CompactionRL:压缩入强化学习》
本文讨论的论文是 CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents,arXiv:2607.05378,由清华大学(Tsinghua University)的 Yujiang Li、Zhenyu Hou、Yi Jing、Jie Tang 和 Yuxiao Dong 五位研究者完成。
In AI, RL, 1 min read
一分钟读论文:《AgentGym2:去理想化评估》
如果你正在构建生产级 AI 智能体,你可能已经发现一个令人不安的事实:在基准测试上表现优异的模型,在实际部署中却频频翻车。
In AI, ParadigmRadar, 2 mins read
一分钟读论文:《双时间尺度递归自我改进架构》
本文讨论的论文是 MetaSkill-Evolve: Recursive Self-Improvement of LLM Agents via Two-Timescale Meta-Skill Evolution,arXiv:2607.05297,由慕尼黑大学(LMU Munich)的 Zefeng Wang、Minxi Yan 等六位研究者完成。
In AI, Agent, 1 min read
一分钟读论文:《SWE-Doctor:诊断引导修Bug》
本文讨论的论文是 SWE-Doctor: Guiding Software Engineering Agents with Runtime Diagnosis from Multi-Faceted Bug Reproduction Tests,arXiv:2607.00990,由新加坡国立大学和中国科学技术大学联合完成。
In AI, SoftwareEngineering, 1 min read
一分钟读论文:《LLM验证器:验证作为第四种缩放轴》
本文讨论的论文是 LLM-as-a-Verifier: A General-Purpose Verification Framework,arXiv:2607.05391,由斯坦福大学和加州大学伯克利分校共九位研究者联合完成。
In AI, LLM, 1 min read
一分钟读论文:《用Lean4验证Agent工作流》
LLM Agent 的工作流设计长期缺乏形式化保障,研究者通常依赖经验性测试和统计评估来判断一个 Agent 流程是否可靠。
In AI, FormalMethods, 1 min read
一分钟读论文:《游戏引擎编码智能体基准测试》
多伦多大学等机构的一篇论文《GameEngineBench: Evaluating Coding Agents on Real C++ Runtime Environments》(arXiv:2607.03525),提出了首个面向游戏引擎开发的编码智能体基准测试 GameEngineBench,发现最强模型在真实 C++ 编译验证下的 pass@1 仅为 55.5%,且 31 个任务(28.2%)对所有评估配置均不可解。
In Engineering, AI, 1 min read
一分钟读论文:《自主策略演化评估框架》
阿里巴巴达摩院合作的一篇论文《EvoPolicyGym: Evaluating Autonomous Policy Evolution in Interactive Environments》首次将”自主策略演化”形式化为独立评估设定——在固定交互预算内,Harness-Model Agent反复编辑可执行策略系统,评估其如何迭代提升已探索的策略。
In ai, agent, 1 min read
Featured
-
一分钟读论文:《Scratch Copilot:用 AI 支持青少年创意编程》推荐
In AI, 编程教育, -
一分钟读论文:《技术债的普遍性、原因和影响:业界系统调查》推荐
In Engineering, Architecture, -
一分钟读论文:《玩转 GitHub 开源软件社区的必备技能树》推荐
In OpenSource, Engineer, -
一分钟读论文:《ChatGPT 提示模式:提高代码质量、重构、需求获取和软件设计》
In AI, Engineering, Engineer, -
一分钟读论文:《用 Rust 和 WebAssembly 补充 JS 实现高性能 Node、Web 应用程序》
In Architecture, Performance, -
一分钟读论文:《通过反思性目标设定培养工程师的好习惯》
In Engineer, Productivity, -
一分钟读论文:《卓越的开源维护者是如何成就的?》
In OpenSource, Engineer, -
一分钟读论文:《我们走了多远——WebAssembly 运行时的全面特征研究》
In FrontEnd, -
一分钟读论文:《XSS 攻击22年:全面调查及系统综述》
In Security, -
一分钟读论文:《细孔沉千帆:小程序权限漏洞研究》
In Security, -
一分钟读论文:《影响大规模敏捷软件开发按时交付的因素》
In Productivity, -
一分钟读论文:《被掏空的一天:软件工程师的日常》
In Productivity, Engineer, -
一分钟读论文:《30年软件重构研究:系统性文献综述》
In Engineering, -
一分钟读论文:《要不要上 TypeScript?GitHub 上 JS 和 TS 应用软件质量的系统比较》
In FrontEnd, -
一分钟读论文:《NPM 供应链的软肋是什么?》
In Security,