All 392
一分钟读论文:《PAST-Bench:自改进基准》
香港中文大学和阿里巴巴集团合作的一篇论文《PAST-Bench: Benchmarking the Foundations of Recursive Self-Improvement in Personal Agents》,首次提出了针对个人 AI 智能体递归自我改进能力的系统性基准测试框架。
In AI, AgentFoundationModels, 1 min read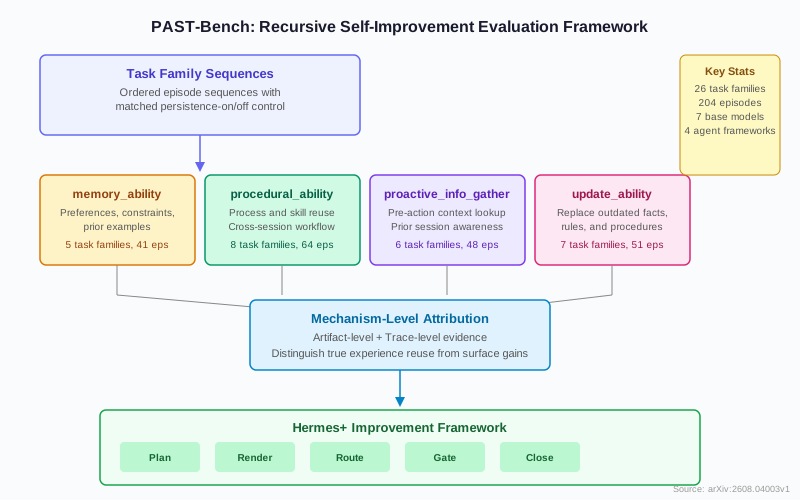
一分钟读论文:《跨会话滥用:能力累积检测》
华盛顿大学的论文《Magnet: Detecting Cross-Session AI Misuse Through Capability Accumulation》(arXiv:2608.02518)指出单会话检测的结构性盲区:拆进多个隔离会话的攻击链,每个会话单独审核都合规。
In AI, Security, 1 min read
一分钟读论文:《编码 Agent 的分层经验复用》
Concordia University 与华为团队的论文《Reusing Past Repairs Through Hierarchical Trajectory Abstraction》(arXiv:2607.29658)提出把历史修复轨迹变成可复用计划的 STAIR 框架。
In AI, LLM, 1 min read
AI 范式雷达:《Agent推理时扩展的预算分配》
如果你正在构建 AI 智能体,你可能已经发现一个越来越明显的瓶颈:无论你的 Agent 是处理简单的工具调用还是复杂的逻辑推理,它消耗的推理计算量几乎是一样的。
In AI, ParadigmRadar, 7 mins read
一分钟读论文:《Agent 的推理预算该动态分配》
韩国研究团队的论文《Rethinking Inference-Time Scaling in Local Computer-Use Agents》(arXiv:2607.28573)实证研究 Agent 场景的 test-time compute:额外计算不提高成功率。
In AI, LLM, 1 min read
一分钟读论文:《Beacon:强化学习驱动视觉推理》
多机构研究团队发表的论文《Beacon: Knowing When and How to Perform Agentic Visual Reasoning》提出了 Mode Adaptiveness(MA)和 Tool Effect(TE)双维度分析框架,实验显著降低了工具滥用率。
In AI, ComputerVision, 1 min read
AI 范式雷达:《Agentic RAG:检索学会自我反思》
如果你正在构建一个需要回答复杂问题的 AI 应用,你可能已经发现传统 RAG 的天花板:当用户问”某公司的 CEO 在哪个大学获得了什么学位?”时,一次向量检索往往只能命中其中一个事实片段,答案要么不完整,要么干脆产生幻觉。
In AI, ParadigmRadar, 3 mins read
一分钟读论文:《LLM多智能体系统扩展原则》
德国埃尔朗根-纽伦堡大学等机构的研究团队发表的论文《Scaling LLM-Driven Multi-Agent Systems: Design Principles and Architectural Scalability Analysis》发现,缩放带来约线性的成本增长和可测量的准确率提升。
In AI, Engineering, 1 min read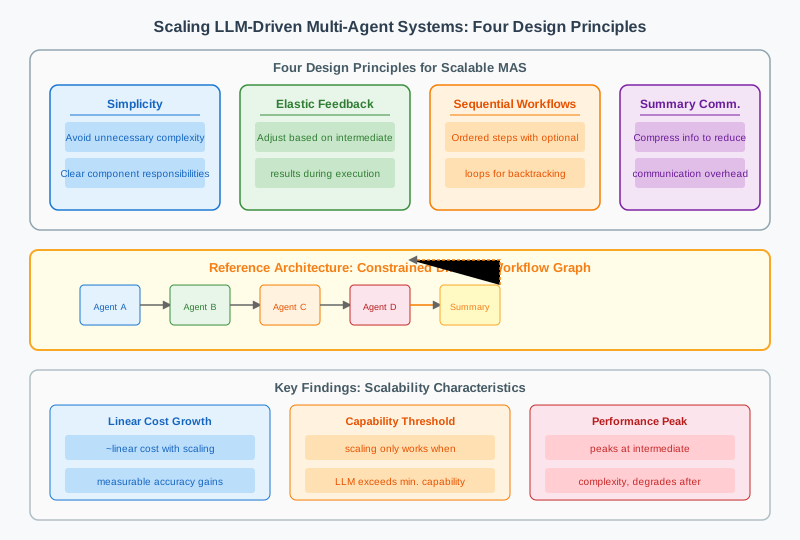
一分钟读论文:《本地计算机使用Agent的推理时扩展》
韩国研究团队发表的论文《Rethinking Inference-Time Scaling in Local Computer-Use Agents: Failure Modes and Compute Tradeoffs》评估四个开源模型在 OSWorld 上的表现后发现,额外计算只改变失败模式,不提高成功率。
In AI, Engineering, 1 min read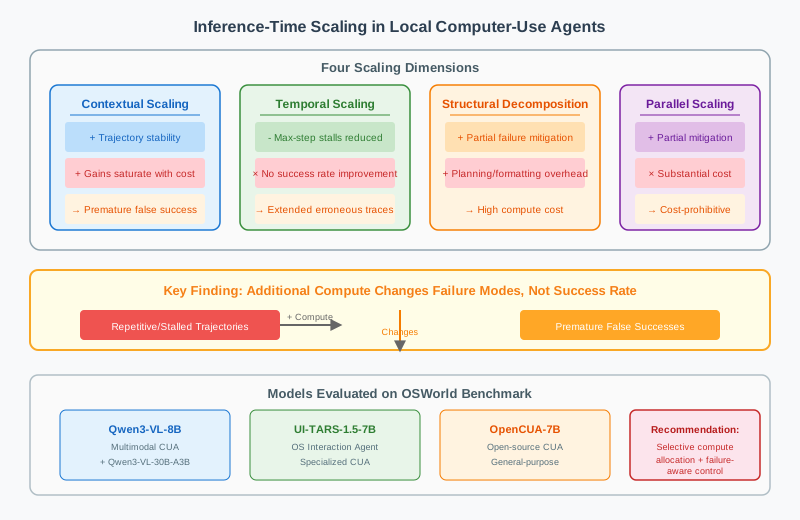
一分钟读论文:《ORCA-bench:On-Call考验》
研究团队发表的论文《ORCA-bench: How Ready Are Language Model Agents for Oncall?》提出了一个生产保真度的根因分析基准测试,将通用编码 Agent 置于真实的生产环境中进行评估。
In AI, Engineering, 1 min read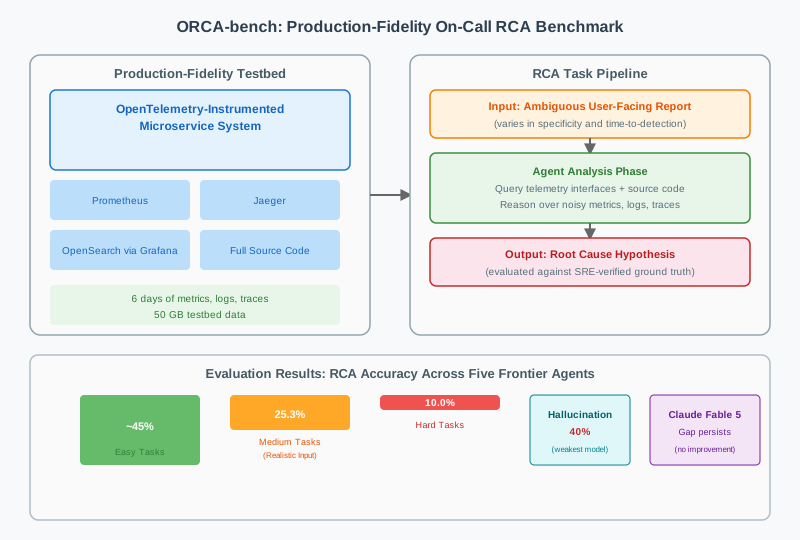
Featured
-
一分钟读论文:《Scratch Copilot:用 AI 支持青少年创意编程》推荐
In AI, 编程教育, -
一分钟读论文:《技术债的普遍性、原因和影响:业界系统调查》推荐
In Engineering, Architecture, -
一分钟读论文:《玩转 GitHub 开源软件社区的必备技能树》推荐
In OpenSource, Engineer, -
一分钟读论文:《ChatGPT 提示模式:提高代码质量、重构、需求获取和软件设计》
In AI, Engineering, Engineer, -
一分钟读论文:《用 Rust 和 WebAssembly 补充 JS 实现高性能 Node、Web 应用程序》
In Architecture, Performance, -
一分钟读论文:《通过反思性目标设定培养工程师的好习惯》
In Engineer, Productivity, -
一分钟读论文:《卓越的开源维护者是如何成就的?》
In OpenSource, Engineer, -
一分钟读论文:《我们走了多远——WebAssembly 运行时的全面特征研究》
In FrontEnd, -
一分钟读论文:《XSS 攻击22年:全面调查及系统综述》
In Security, -
一分钟读论文:《细孔沉千帆:小程序权限漏洞研究》
In Security, -
一分钟读论文:《影响大规模敏捷软件开发按时交付的因素》
In Productivity, -
一分钟读论文:《被掏空的一天:软件工程师的日常》
In Productivity, Engineer, -
一分钟读论文:《30年软件重构研究:系统性文献综述》
In Engineering, -
一分钟读论文:《要不要上 TypeScript?GitHub 上 JS 和 TS 应用软件质量的系统比较》
In FrontEnd, -
一分钟读论文:《NPM 供应链的软肋是什么?》
In Security,